6. Lokale und cloudbasierte Modelle
Lokale und cloudbasierte Modelle
Abschnitt betitelt „Lokale und cloudbasierte Modelle“Die Frage „welches Modell” wird meist zuerst gestellt und ist selten die wichtigste. Die wichtigere lautet: Wo läuft es, und was verlässt dabei das Haus? Davon hängen Datenschutz, Kosten, Verfügbarkeit und die Frage ab, was Sie überhaupt einsetzen dürfen.
Zwei Betriebsarten
Abschnitt betitelt „Zwei Betriebsarten“Cloud (API). Ihr Programm schickt den Prompt über HTTPS an einen Anbieter, dort läuft das Modell auf spezialisierter Hardware, die Antwort kommt zurück. Abgerechnet wird pro Token (Kapitel 4). Sie brauchen keine Hardware, keine Wartung, keine Kapazitätsplanung. Der Preis dafür ist: Der Prompt liegt für die Dauer der Verarbeitung auf fremder Infrastruktur, und ohne Vertrag oder Zusage wissen Sie nicht, wie lange darüber hinaus.
Lokal (Self-Hosting). Sie laden Modellgewichte herunter und führen das Modell auf eigener Hardware aus, auf dem Notebook, auf einem Server im Haus, in einer VM beim Hoster. Nichts verlässt die Maschine. Sie bezahlen keine Tokens, sondern Hardware und Strom, und Sie tragen den Betrieb.
Die Sprache ist hier unpräzise. „Offene Modelle” heißt in der Regel offene Gewichte: Man darf die Gewichtsdateien herunterladen und ausführen. Trainingsdaten und Trainingscode sind meist nicht offen, und die Lizenzen sind unterschiedlich, von echten Open-Source-Lizenzen bis zu Bedingungen mit Nutzungsbeschränkungen. Wer ein Modell in einem Produkt einsetzt, liest die Lizenz. Das ist keine Formalie.
Was ein lokales Modell an Hardware braucht
Abschnitt betitelt „Was ein lokales Modell an Hardware braucht“Der begrenzende Faktor ist der Grafikspeicher (VRAM). Das ganze Modell muss dort hinein, sonst wird ausgelagert und die Ausführung bricht auf ein Zehntel oder weniger ein.
Der Bedarf ergibt sich aus zwei Zahlen: der Parameterzahl und der Quantisierung, also wie viele Bits pro Parameter gespeichert werden. Ein unquantisiertes Modell verwendet 16 Bit (2 Byte) pro Parameter. Quantisierung reduziert das auf 8, 5 oder 4 Bit und kostet dafür ein wenig Qualität.
Bedarf ≈ Parameterzahl × Bytes pro Parameter × 1,2 (grober Aufschlag für Kontext)
8 Mrd. Parameter, 4 Bit  ≈ 8 × 0,5 × 1,2 =  ~5 GB8 Mrd. Parameter, 16 Bit ≈ 8 × 2,0 × 1,2 = ~19 GB70 Mrd. Parameter, 4 Bit ≈ 70 × 0,5 × 1,2 = ~42 GB
Der Faktor 1,2 ist eine Abkürzung für einen Posten, der bei langem Kontext alles andere überholen kann. Der nächste Abschnitt rechnet ihn richtig aus.
| Modellgröße | Quantisierung | VRAM | Läuft auf |
|---|---|---|---|
| 3 bis 4 Mrd. | 4 Bit | ~3 GB | fast jedem aktuellen Notebook |
| 7 bis 9 Mrd. | 4 Bit | ~5 bis 6 GB | Mittelklasse-GPU, Apple Silicon |
| 14 bis 20 Mrd. | 4 Bit | ~10 bis 14 GB | gute Consumer-GPU |
| 30 bis 40 Mrd. | 4 Bit | ~20 bis 26 GB | obere Consumer-Klasse |
| 70 Mrd. | 4 Bit | ~42 GB | zwei GPUs oder Server-Hardware |
Für Q4 gilt als Erfahrungswert, dass der Qualitätsverlust gegenüber der unquantisierten Fassung gering ist und die Halbierung des Speicherbedarfs ihn fast immer aufwiegt. Unter 4 Bit wird es merklich schlechter. Apple Silicon ist ein Sonderfall, weil Arbeits- und Grafikspeicher gemeinsam genutzt werden: Ein Rechner mit 32 GB kann Modelle laden, für die auf einem PC eine Server-GPU nötig wäre.
Der KV-Cache
Abschnitt betitelt „Der KV-Cache“Aus Kapitel 3: Attention erzeugt zu jedem Token drei Vektoren. Die Query sagt, wonach das Token sucht, der Key, wofür es gefunden werden will, und der Value ist sein Bedeutungsbeitrag, wenn es gefunden wurde. Um ein neues Token zu erzeugen, vergleicht das Modell dessen Query mit den Keys aller vorangegangenen Tokens und mischt deren Values entsprechend.
Die vorangegangenen Keys und Values müssten also bei jedem einzelnen Schritt bereitstehen. Man könnte sie jedes Mal neu berechnen, dann wäre ein Text von n Tokens eine quadratische Angelegenheit. Das ist auch nicht nötig, denn bei der Generierung schaut jedes Token nur nach hinten: K und V eines Tokens hängen allein von diesem Token und seiner Position ab, nicht von dem, was danach kommt. Einmal berechnet, ändern sie sich nie wieder.
Also berechnet man sie einmal und hebt sie auf. Diese Ablage heißt KV-Cache. Die Queries werden nicht aufgehoben, weil in jedem Schritt nur die des neuen Tokens gebraucht wird und alte nie wieder.
Schritt 1: "Der Server konnte" → K,V für 3 Tokens berechnen und ablegenSchritt 2: neues Token "die" → nur dessen Q, K, V berechnen K,V anhängen, Q gegen 4 gespeicherte KSchritt 3: neues Token "Anfrage" → nur dessen Q, K, V berechnen K,V anhängen, Q gegen 5 gespeicherte KPro Schritt ist damit genau ein Token neu zu verarbeiten statt aller bisherigen. Der KV-Cache ist der Grund, warum Textgenerierung überhaupt praktikabel ist, und daraus folgen vier Dinge, die man im Betrieb ständig braucht.
Zwei Phasen mit sehr verschiedenem Verhalten
Abschnitt betitelt „Zwei Phasen mit sehr verschiedenem Verhalten“flowchart LR A["Prefill<br/>Der gesamte Prompt wird<br/>auf einmal verarbeitet"] --> B["KV-Cache gefüllt"] B --> C["Decode<br/>Token für Token,<br/>je Schritt ein Anhängen an den Cache"] C --> C
Im Prefill wird der Prompt in einem Durchgang verarbeitet. Alle Tokens lassen sich parallel rechnen, die GPU ist voll ausgelastet, der Vorgang ist rechenbegrenzt und pro Token sehr schnell.
Im Decode entsteht ein Token nach dem anderen. Für jedes einzelne müssen die Modellgewichte und der gesamte bisherige KV-Cache aus dem Speicher gelesen werden, während vergleichsweise wenig gerechnet wird. Der Vorgang ist speicherbandbreitenbegrenzt und pro Token um ein Vielfaches langsamer.
Das ist die technische Erklärung für eine Zahl aus Kapitel 4: Ausgabe-Tokens kosten das Vier- bis Fünffache von Eingabe-Tokens, weil sie in der teuren Phase entstehen. Wer den Preisunterschied bisher als Geschäftsentscheidung gelesen hat, sieht hier den Grund dahinter.
Der KV-Cache belegt Speicher, und zwar viel
Abschnitt betitelt „Der KV-Cache belegt Speicher, und zwar viel“Neben den Gewichten ist er der zweite große Posten im VRAM. Seine Größe hängt nicht von der Parameterzahl ab, sondern von der Architektur und von der Kontextlänge:
KV-Cache = 2 × Schichten × KV-Köpfe × Kopfdimension × Bytes je Wert × Tokens           ↑           K und V
Beispiel: 8-Mrd.-Modell, 32 Schichten, 8 KV-Köpfe, Kopfdimension 128, fp16
pro Token: 2 × 32 × 8 × 128 × 2 Byte = 131.072 Byte ≈ 128 KiB
  8.192 Tokens Kontext →  ~1 GB 32.768 Tokens Kontext →  ~4 GB131.072 Tokens Kontext → ~16 GB
Die beiden Faktoren am Anfang erklären sich aus dem Vorigen: Die 2 steht für die zwei Vektoren K und V, die Schichtenzahl dafür, dass jede Schicht des Modells ihre eigene Attention-Rechnung mit eigenen K und V hat. Beides fällt für jedes Token an, das im Kontext steht.
Die Gewichte dieses Modells brauchen in Q4 etwa 5 GB. Bei 128k Kontext belegt der KV-Cache also das Dreifache der Gewichte. Genau das übersieht man, wenn man nur die Modellgröße betrachtet und dann feststellt, dass eine 8-GB-Karte das 8-Milliarden-Modell zwar lädt, aber bei langem Kontext trotzdem auslagert.
Prompt Caching ist ein aufgehobener KV-Cache
Abschnitt betitelt „Prompt Caching ist ein aufgehobener KV-Cache“In Kapitel 4 stand, dass der Anbieter „den verarbeiteten Zustand des Prompt-Anfangs” behält. Dieser Zustand ist genau der KV-Cache für dieses Präfix. Damit erklärt sich auch die Bedingung, die dort etwas willkürlich wirkte: Ein K/V-Wert an Position n ist unter Einbeziehung aller Tokens davor berechnet worden. Ändert sich eines davon, sind alle folgenden Werte falsch. Deshalb muss der Präfix Byte für Byte übereinstimmen, und deshalb macht ein Zeitstempel im System-Prompt den gesamten Cache dahinter wertlos.
Stellschrauben
Abschnitt betitelt „Stellschrauben“- Kontextlänge begrenzen. Der wirksamste Hebel lokal. Wer 8k statt 128k einstellt, spart im Beispiel oben 15 GB.
- KV-Cache quantisieren. Statt fp16 lässt sich der Cache in 8 Bit ablegen, was ihn halbiert. Der Qualitätsverlust ist bei
q8_0gering; inllama.cppüber--cache-type-k/--cache-type-v, in Ollama überOLLAMA_KV_CACHE_TYPE. - Speicherverwaltung im Serverbetrieb. Wenn mehrere Sitzungen gleichzeitig laufen, wird die Verwaltung des Cache zum Engpass. Reserviert man je Sitzung den vollen Kontext, bleibt der meiste Speicher ungenutzt liegen. Serving-Systeme lösen das mit seitenweiser Verwaltung (PagedAttention in vLLM) oder tokenweiser (Token Attention in LightLLM), was die Zahl gleichzeitiger Sitzungen auf derselben Karte deutlich erhöht.
Mixture of Experts
Abschnitt betitelt „Mixture of Experts“Die Rechnung oben unterstellt, dass für jedes Token alle Parameter des Modells gebraucht werden. Bei einem dichten (dense) Modell stimmt das. Bei einem Mixture-of-Experts-Modell (MoE) nicht, und das verschiebt die ganze Kalkulation.
In einem MoE-Modell ist der Feed-Forward-Block jeder Schicht nicht ein Netz, sondern eine Sammlung von N Experten. Ein kleiner Router entscheidet pro Token, welche k davon rechnen; die übrigen bleiben unberührt. Die Attention-Schichten sind weiterhin für alle gemeinsam.
flowchart TB
  T["Token"] --> R{"Router"}
  R -->|gewählt| E1["Experte 1"]
  R -.->|übersprungen| E2["Experte 2"]
  R -.->|übersprungen| E3["Experte 3"]
  R -->|gewählt| E4["Experte 4"]
  R -.->|übersprungen| E5["… Experte N"]
  E1 --> S["Ergebnis"]
  E4 --> S
Damit hat ein MoE-Modell zwei Parameterzahlen, und beide stehen in den Modellnamen: Eine Bezeichnung wie 30B-A3B heißt 30 Milliarden Parameter insgesamt, davon 3 Milliarden je Token aktiv.
| Dichtes Modell | MoE-Modell | |
|---|---|---|
| Parameter je Token aktiv | alle | ein Bruchteil |
| Speicherbedarf richtet sich nach | Gesamtparametern | Gesamtparametern |
| Rechenaufwand und Geschwindigkeit richten sich nach | Gesamtparametern | aktiven Parametern |
| Qualität bei gleichem Speicher | besser | schlechter |
| Qualität bei gleichem Rechenaufwand | schlechter | besser |
Die beiden fett gesetzten Zeilen sind die ganze Sache: Ein MoE-Modell belegt Speicher wie ein großes Modell und rechnet wie ein kleines. Für die Entscheidung, was auf welcher Maschine läuft, hat das zwei Folgen.
Erstens taugt die VRAM-Tabelle weiter oben unverändert, denn sie geht von den Gesamtparametern aus. Ein MoE-Modell wird durch seine Bauweise nicht kleiner, es lädt vollständig.
Zweitens ist die erreichbare Geschwindigkeit besser, als die Größe vermuten lässt. Ein Modell mit 100 Milliarden Gesamt- und 5 Milliarden aktiven Parametern erzeugt Tokens ungefähr im Tempo eines 5-Milliarden-Modells, sofern es in den Speicher passt. Das macht MoE-Modelle für Maschinen mit viel gemeinsamem Speicher interessant, etwa Apple Silicon mit 64 oder 128 GB, und es ist der Grund, warum sich Verfahren lohnen, die Attention und Router auf der GPU halten und die Experten im Arbeitsspeicher liegen lassen: Pro Token wird ohnehin nur ein Bruchteil davon angefasst.
Werkzeuge zum Ausführen
Abschnitt betitelt „Werkzeuge zum Ausführen“Die Werkzeuglandschaft zerfällt in zwei Gruppen mit verschiedenen Zielen: Programme für einen Arbeitsplatz und Systeme für den gemeinsamen Betrieb im Haus. Wer das eine für das andere einsetzt, bekommt Probleme, die schwer zuzuordnen sind.
llama.cpp und GGUF
Abschnitt betitelt „llama.cpp und GGUF“Die Grundlage, auf der ein großer Teil des lokalen Ökosystems aufsetzt, darunter Ollama und LM Studio. Eine C/C++-Implementierung, die auf CPU und GPU läuft und die üblichen Beschleuniger bedient (CUDA, Metal, Vulkan, ROCm).
Sie bringt auch das Dateiformat mit, dem Sie überall begegnen: GGUF hält Gewichte, Tokenizer und Metadaten in einer einzigen Datei. Die Quantisierung steht im Dateinamen, etwa modell-Q4_K_M.gguf. Als Voreinstellung ist Q4_K_M die übliche Wahl, Q5_K_M bei genug Speicher, Q8_0 wenn Speicher keine Rolle spielt.
# Server with an OpenAI-compatible interfacellama-server -m model-Q4_K_M.gguf \ -c 8192 \ # context length, determines the KV cache -ngl 99 \ # offload as many layers as possible to the GPU --cache-type-k q8_0 \ # KV cache in 8 bit, halves its size --cache-type-v q8_0 \ --port 8080Der Parameter -ngl ist der wichtigste für die Geschwindigkeit: Er legt fest, wie viele Schichten auf die GPU wandern. Passt nicht alles, laufen die restlichen auf der CPU, und das kostet je nach Aufteilung den Faktor fünf bis zwanzig. llama.cpp ist der richtige Weg, wenn Sie messen und optimieren wollen, weil hier jede Stellschraube offenliegt.
Der bequemste Einstieg. Verwaltet Modelle wie ein Paketmanager, kümmert sich um Download, Speicher und Laufzeit und stellt eine HTTP-Schnittstelle auf 127.0.0.1:11434 bereit, gegen die sich die meisten Werkzeuge anbinden lassen. Es gibt daneben einen OpenAI-kompatiblen Pfad unter /v1, was Bibliotheken ohne eigene Ollama-Unterstützung genügt.
ollama pull qwen2.5-coder:7bollama run qwen2.5-coder:7bollama ps # what is loaded, how much memory, how much time is leftollama list # what is stored on diskWeitere Umgebungsvariablen, die im Alltag zählen: OLLAMA_KEEP_ALIVE (wie lange ein Modell nach der letzten Anfrage geladen bleibt, sonst zahlen Sie die Ladezeit immer wieder), OLLAMA_NUM_PARALLEL (gleichzeitige Anfragen) und OLLAMA_HOST, wenn der Dienst über das Netz erreichbar sein soll. Letzteres ist ein Sicherheitsschritt: Ollama bringt keine Authentifizierung mit, ein offener Port ist ein offener Dienst.
LM Studio
Abschnitt betitelt „LM Studio“Grafische Oberfläche mit Modellkatalog. Der Katalog zeigt zu jedem Modell an, ob und wie es auf die vorhandene Hardware passt, was am Anfang mehr wert ist als jede Faustformel. Dazu ein Chatfenster, ein Serverbetrieb mit OpenAI-kompatibler Schnittstelle und eine Anzeige der erreichten Tokens pro Sekunde.
Für den Unterricht ist das der schnellste Weg, ein Gefühl für die Größenordnungen zu bekommen: Dasselbe Modell in drei Quantisierungsstufen laden und die Geschwindigkeit ablesen dauert zehn Minuten und ersetzt eine Menge Theorie.
Zentral im Haus
Abschnitt betitelt „Zentral im Haus“Die drei bisherigen Werkzeuge sind für einen Benutzer gebaut. Sobald eine Abteilung oder eine Schule gemeinsam auf eine Maschine zugreift, ändern sich die Anforderungen: Durchsatz statt Einzelgeschwindigkeit, viele gleichzeitige Sitzungen auf derselben Karte, Authentifizierung, Kontingente, Protokollierung.
Dafür gibt es eigene Inference-Server. Ihr gemeinsames Merkmal ist Continuous Batching: Statt Anfragen nacheinander abzuarbeiten, laufen viele Sitzungen gleichzeitig durch das Modell, und fertige Sitzungen werden sofort durch wartende ersetzt. Zusammen mit der Speicherverwaltung des KV-Cache bringt das auf derselben Hardware ein Vielfaches des Durchsatzes.
LightLLM ist eine solche Lösung, in Python geschrieben und auf Durchsatz ausgelegt. Kennzeichnend ist die tokenweise Verwaltung des KV-Cache (Token Attention), die Speicherverschnitt zwischen Sitzungen vermeidet, dazu die überlappende Abarbeitung von Tokenisierung, Inferenz und Detokenisierung, Tensor-Parallelität über mehrere GPUs und Quantisierung der Gewichte. Nach außen bietet es eine OpenAI-kompatible Schnittstelle, sodass vorhandene Clients unverändert weiterarbeiten.
In derselben Kategorie stehen vLLM, SGLang und TGI. Die Auswahl trifft man nicht nach Marketingzahlen, sondern durch Messen mit der eigenen Last: Anfragen pro Sekunde, gleichzeitige Sitzungen, typische Prompt- und Antwortlängen.
Darüber sitzt noch etwas, das in der Aufzählung leicht untergeht: eine Oberfläche für Menschen. Agenten und Anwendungen sprechen den Endpunkt selbst an, aber die Mehrheit der Belegschaft arbeitet nicht im Terminal und schreibt keinen Code. Für sie braucht es ein Chatfenster.
Das verbreitetste Werkzeug dafür ist Open WebUI: eine selbst gehostete Weboberfläche, die als Container läuft, selbst kein Modell ausführt und sich an Ollama oder jede OpenAI-kompatible Schnittstelle hängt. Sie bringt genau das mit, was den Arbeitsplatzwerkzeugen weiter oben fehlt, nämlich Anmeldung, Benutzerrollen und Rechte, dazu Modellauswahl, geteilte Prompt-Sammlungen und Dokumenten-Upload.
flowchart LR
  U["Weboberfläche<br/>(Open WebUI)<br/>für alle ohne Terminal"] --> G
  A["Anwendungen,<br/>IDEs, Agenten"] --> G["Gateway<br/>ein Endpunkt, Schlüssel je Team,<br/>Budgets, Protokoll"]
  G --> L["Inference-Server im Haus<br/>(LightLLM, vLLM, …)<br/>auf eigenen GPUs"]
  G --> C["Externer Anbieter<br/>für die schweren Fälle"]
Die drei Schichten haben klar getrennte Aufgaben, und das ist der Grund, warum man sie einzeln austauschen kann: Die Oberfläche zeigt an, das Gateway entscheidet und verrechnet, der Inference-Server rechnet. Ein Wechsel des Modells berührt die Oberfläche nicht, und eine zweite Oberfläche für eine andere Abteilung braucht keine Änderung darunter.
Die Aufteilung ist zugleich die technische Umsetzung des hybriden Ansatzes am Ende dieses Kapitels: Das Gateway entscheidet je nach Aufgabe und Vertraulichkeit, ob eine Anfrage das Haus verlässt. Oberfläche und Anwendungen sehen davon nichts, weil sie ohnehin nur einen Endpunkt kennen.
Offene Modelle und wo man sie findet
Abschnitt betitelt „Offene Modelle und wo man sie findet“Offene Modelle liegen fast ausnahmslos an einer Stelle: auf Hugging Face. Die Plattform ist für Modelle das, was eine Paketregistry für Bibliotheken ist, also Ablage, Versionierung und Metadaten in einem. Ein Eintrag heißt dort Repository und trägt immer die Form namensraum/modellname.
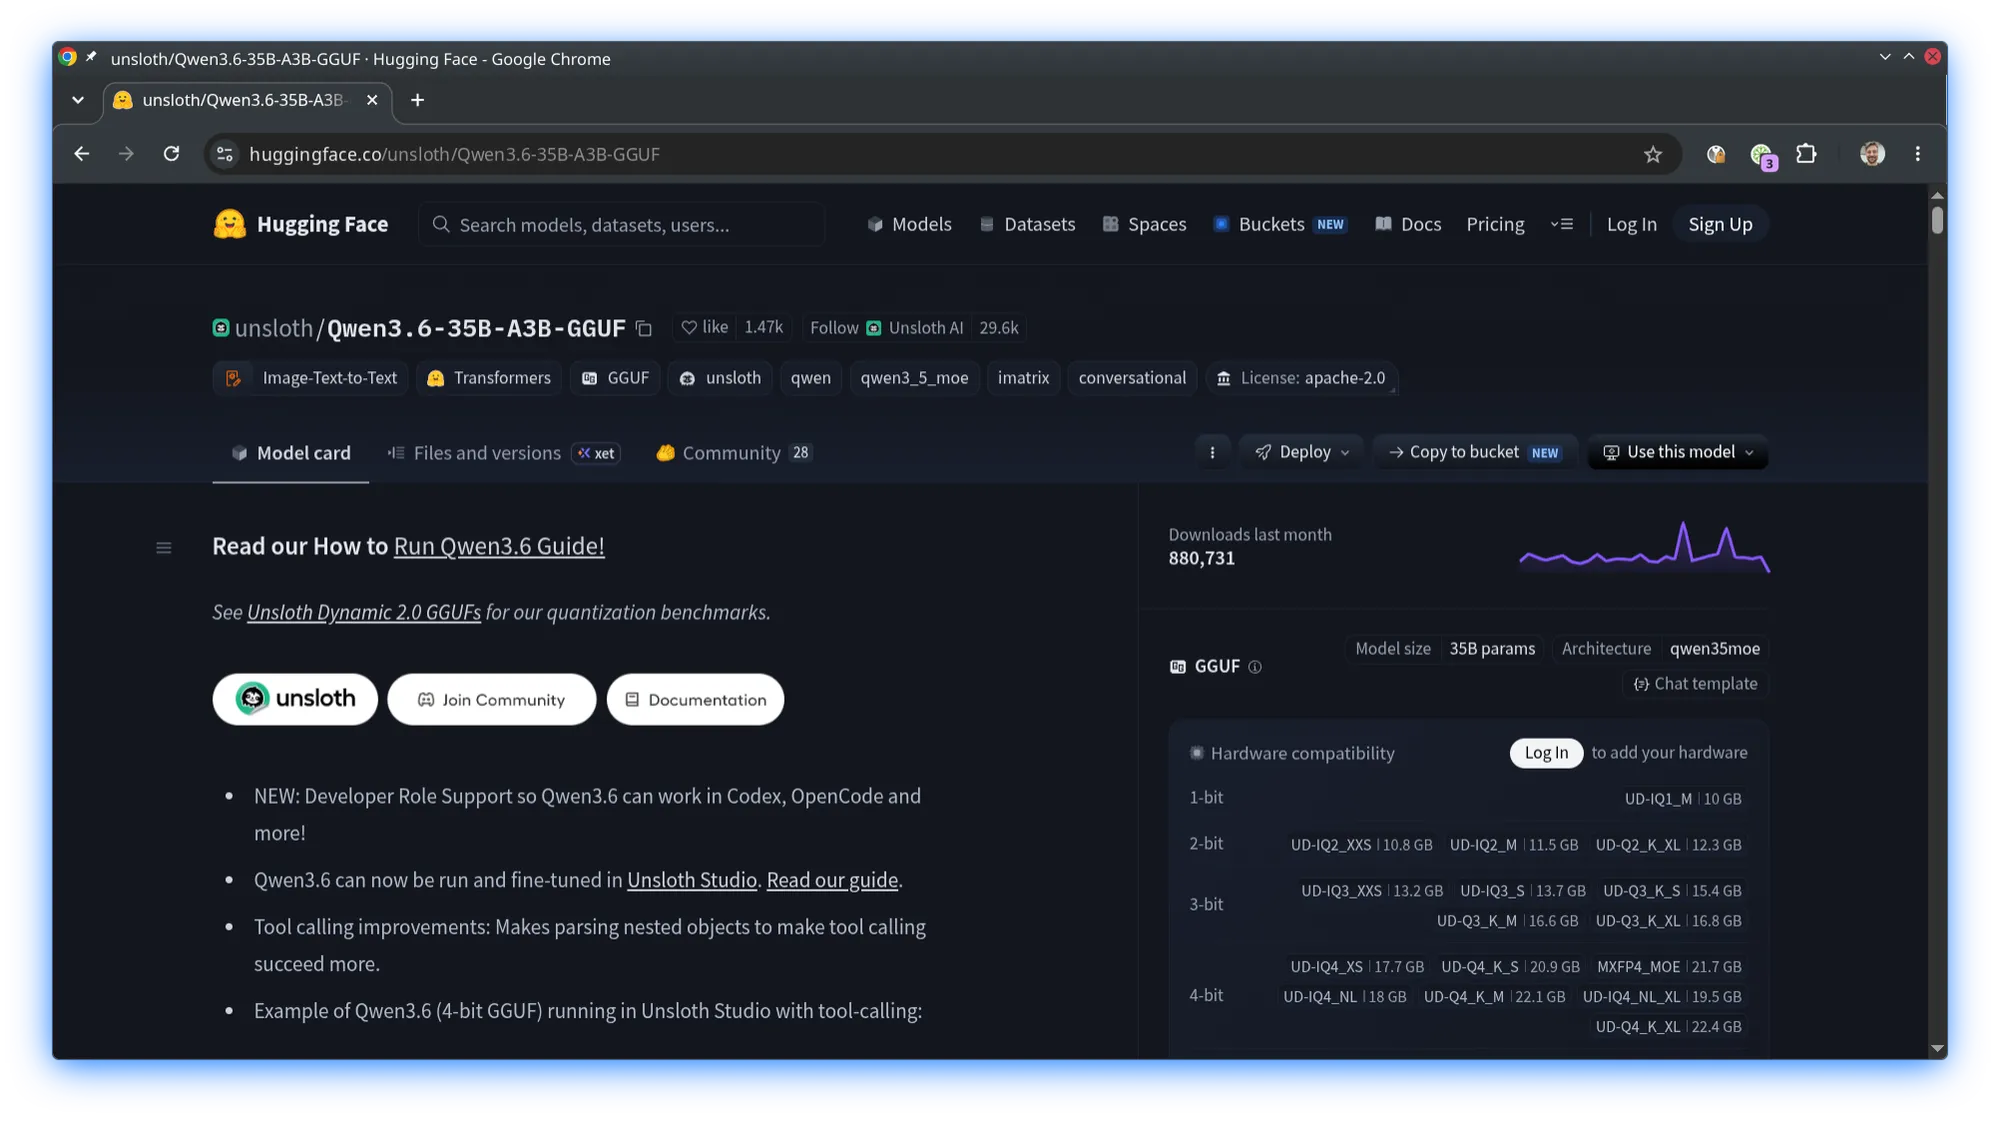
Der Modellname zerlegt
Abschnitt betitelt „Der Modellname zerlegt“Der Name unsloth/Qwen3.6-35B-A3B-GGUF sieht kryptisch aus, ist aber vollständig lesbar. Er besteht aus fünf Teilen, und jeder beantwortet eine eigene Frage.
| Teil | Bedeutung |
|---|---|
unsloth | Namensraum: wer das Repository hochgeladen hat |
Qwen3.6 | Modellfamilie und Version des ursprünglichen Herstellers |
35B | Gesamtparameter: 35 Milliarden, bestimmt den Speicherbedarf |
A3B | aktive Parameter: 3 Milliarden je Token, bestimmt die Geschwindigkeit |
GGUF | Dateiformat, hier die für llama.cpp aufbereitete Fassung |
Der Namensraum ist nicht der Hersteller. unsloth ist ein Anbieter, der fremde Modelle quantisiert und neu veröffentlicht. Das Originalmodell liegt unter Qwen/… beim Hersteller, dieses Repository ist ein Derivat. Das ist der Normalfall bei GGUF-Dateien und völlig legitim, hat aber zwei Konsequenzen: Die Lizenz stammt weiterhin vom Original (hier apache-2.0, im Screenshot als Schlagwort sichtbar), und Sie vertrauen beim Download zusätzlich dem Umpacker. Für die bekannten Namen wie unsloth, bartowski oder TheBloke ist das üblich; bei einem unbekannten Konto lädt man Gewichte so wenig blind herunter wie ein Container-Image.
35B-A3B ist die MoE-Notation aus dem vorigen Abschnitt. Beide Zahlen zusammen ergeben erst ein Bild: Geladen werden 35 Milliarden Parameter, gerechnet wird je Token mit 3 Milliarden. Nach der VRAM-Tabelle weiter oben liegt das in Q4 bei gut 20 GB, im Screenshot bestätigt die Zeile UD-Q4_K_XL | 22.4 GB genau das. Die Geschwindigkeit entspricht dagegen ungefähr der eines 3-Milliarden-Modells. Ein dichtes 35-Milliarden-Modell würde denselben Speicher belegen und wäre um ein Vielfaches langsamer.
GGUF ist eine Aussage über das Format, nicht über die Qualität. Ein Repository ohne dieses Kürzel enthält in der Regel die unquantisierten Gewichte im Transformers-Format, gedacht für Training, Feinabstimmung und Server wie vLLM. Wer lokal mit Ollama, LM Studio oder llama.cpp arbeitet, braucht die GGUF-Fassung.
Die Quantisierungsstufe steht nicht im Repositorynamen, sondern im Dateinamen. Ein GGUF-Repository enthält dieselben Gewichte in vielen Stufen nebeneinander, im Screenshot von UD-IQ1_M mit 10 GB bis UD-Q4_K_XL mit 22.4 GB. Beim Herunterladen wählt man also nicht nur ein Modell, sondern auch eine Stufe, und diese Wahl entscheidet, ob es auf die eigene Karte passt.
Dasselbe Modell in drei Werkzeugen
Abschnitt betitelt „Dasselbe Modell in drei Werkzeugen“Alle drei lokalen Werkzeuge können direkt von Hugging Face laden, die Gewichte müssen also nicht von Hand heruntergeladen werden. Verlangt wird jeweils dasselbe: das Repository und die gewünschte Quantisierungsstufe.
# Ollama: repository with a leading hf.co/, quantization after the colonollama run hf.co/unsloth/Qwen3.6-35B-A3B-GGUF:UD-Q4_K_XL# llama.cpp: -hf downloads and starts in a single stepllama-server -hf unsloth/Qwen3.6-35B-A3B-GGUF:UD-Q4_K_XL \ -c 8192 \ # set the context length deliberately -ngl 99 \ # all layers on the GPU --cache-type-k q8_0 \ --cache-type-v q8_0 \ --port 8080In LM Studio geschieht dasselbe über die Oberfläche: Im Suchfeld unsloth/Qwen3.6-35B-A3B-GGUF eingeben, in der Trefferliste die Quantisierungsstufe wählen und laden. Der Katalog markiert dabei, welche Stufen auf die vorhandene Hardware passen, was den Umweg über die Rechnung erspart. Wer lieber im Terminal bleibt, nimmt das mitgelieferte lms:
lms get unsloth/Qwen3.6-35B-A3B-GGUF@UD-Q4_K_XLlms server start # OpenAI-compatible on 127.0.0.1:1234Nach dem Start sprechen alle drei eine OpenAI-kompatible Schnittstelle, nur auf verschiedenen Ports: Ollama auf 11434 (unter /v1), llama-server auf dem oben gesetzten 8080, LM Studio auf 1234. Für den anfragenden Code ist der Unterschied damit eine Zeile Konfiguration.
Der Vergleich
Abschnitt betitelt „Der Vergleich“| Cloud | Lokal | |
|---|---|---|
| Beste verfügbare Qualität | ja | nein, mit deutlichem Abstand |
| Daten verlassen das Haus | ja | nein |
| Kosten | pro Token, skaliert mit Nutzung | Hardware einmal, dann fast nichts |
| Einstiegshürde | API-Schlüssel | GPU und Einrichtung |
| Verfügbarkeit | abhängig von Netz und Anbieter | abhängig von der eigenen Maschine |
| Kontextfenster | groß (bis ~1 Mio. Tokens) | meist deutlich kleiner |
| Werkzeugnutzung (Kapitel 8) | verlässlich | schwach bis brauchbar, je nach Modell |
| Reproduzierbarkeit | Modell kann sich ändern | Gewichte bleiben, wie sie sind |
| Betriebsaufwand | keiner | Ihrer |
Zwei Zeilen daraus verdienen Aufmerksamkeit, weil sie im Unterricht regelmäßig unterschätzt werden.
Werkzeugnutzung ist der eigentliche Unterschied. Für agentisches Arbeiten (Kapitel 8) muss ein Modell verlässlich strukturierte Werkzeugaufrufe erzeugen, viele Schritte hintereinander durchhalten und aus Fehlermeldungen lernen. Genau darin sind lokale Modelle im Sommer 2026 schwach. Ein 7-Milliarden-Modell schreibt eine passable Funktion und scheitert daran, in fünfzehn Schritten ein Repository umzubauen. Für Codevervollständigung, Erklärungen und kleine, abgegrenzte Aufgaben sind lokale Modelle brauchbar; für längere autonome Läufe sind sie es derzeit nicht.
Reproduzierbarkeit spricht für lokal. Ein Cloud-Modell hinter demselben Namen kann morgen anders antworten, und ältere Modelle werden abgeschaltet. Wer eine Anwendung baut, deren Verhalten über Jahre gleich bleiben muss, hat mit heruntergeladenen Gewichten ein Argument, das man nicht kaufen kann.
Datenschutz: was in einen Prompt darf
Abschnitt betitelt „Datenschutz: was in einen Prompt darf“Hier hört der technische Teil auf und der rechtliche fängt an. Ein Prompt an einen Cloud-Anbieter ist eine Datenübermittlung an einen Dritten. Sobald darin personenbezogene Daten vorkommen, greift die DSGVO mit allem, was dazugehört: Rechtsgrundlage, Zweckbindung, Datenminimierung, Auftragsverarbeitungsvertrag, Informationspflicht gegenüber den Betroffenen.
Für die Praxis in diesem Gegenstand gilt eine kurze Liste, und sie ist nicht verhandelbar.
Gehört nie in einen Prompt:
- Namen, Adressen, Geburtsdaten, Noten, Fotos von Mitschülerinnen und Mitschülern oder von Kunden
- Zugangsdaten, API-Schlüssel, Tokens, private Schlüssel, Verbindungszeichenketten
- Produktionsdaten aus einem Betrieb, auch anonymisiert klingende Auszüge
- Inhalte, die unter eine Vertraulichkeitsvereinbarung fallen
Ist unproblematisch:
- Eigener Code ohne Geheimnisse und ohne Kundendaten darin
- Fehlermeldungen und Stacktraces, aus denen Pfade und Hostnamen entfernt sind
- Erfundene Testdaten
- Öffentliche Dokumentation
Bei Zweifeln gilt die Ersetzungsregel: Erfundene Daten, die dieselbe Struktur haben, liefern für die Aufgabenstellung dasselbe Ergebnis. Ein Modell, das eine Validierung für Sozialversicherungsnummern schreiben soll, braucht keine echte.
Ergänzend zur Anbieterseite: Seriöse Anbieter bieten Vertragsklauseln zur Auftragsverarbeitung, Zusagen zur Speicherdauer und Optionen, Eingaben vom Training auszunehmen. Diese Zusagen unterscheiden sich zwischen kostenlosen Endnutzer-Angeboten und bezahlten API-Zugängen erheblich, und der Unterschied ist genau der Punkt: Was Sie in ein kostenloses Chatfenster tippen, ist rechtlich etwas anderes als ein API-Aufruf unter Vertrag.
Wie man entscheidet
Abschnitt betitelt „Wie man entscheidet“flowchart TD
A[Anwendungsfall] --> B{Personenbezogene<br/>oder vertrauliche Daten?}
B -->|ja, unvermeidbar| C[Lokal, oder Cloud mit Auftrags-<br/>verarbeitungsvertrag und Prüfung]
B -->|nein| D{Agentisches Arbeiten<br/>über viele Schritte?}
D -->|ja| E[Cloud]
D -->|nein| F{Hardware vorhanden?}
F -->|ja| G[Lokal probieren, messen]
F -->|nein| E
G --> H{Qualität ausreichend?}
H -->|ja| I[Lokal bleiben]
H -->|nein| E
Der praktische Mittelweg heißt hybrid und ist in Betrieben verbreitet: Routineaufgaben mit hohem Volumen und geringem Anspruch laufen lokal oder auf einem kleinen, billigen Cloud-Modell, die schwierigen Fälle gehen an ein großes. Bei einem Kostenunterschied vom Faktor fünf zwischen den Modellklassen eines Anbieters lohnt sich diese Aufteilung schnell. Die Voraussetzung dafür ist eine saubere Abstraktion im Code: Wer den Modellaufruf hinter einer eigenen Schnittstelle kapselt, kann Modelle tauschen, ohne die Anwendung anzufassen. Das ist genau die Mehrschichtarchitektur aus der 4. Klasse, angewendet auf einen neuen Fremddienst.
Häufige Stolperfallen
Abschnitt betitelt „Häufige Stolperfallen“- „Offen” mit „Open Source” gleichsetzen. Offene Gewichte, geschlossene Lizenzbedingungen. Prüfen, bevor man es in ein Produkt einbaut.
- Ein Modell laden, das nicht in den VRAM passt. Es läuft, aber unbrauchbar langsam, und die Ursache steht in keiner Fehlermeldung.
- Nur die Gewichte rechnen, den KV-Cache vergessen. Bei langem Kontext ist er der größere Posten. Das Modell lädt, und beim dritten Prompt wird ausgelagert.
- Den Kontext auf das Maximum stellen, weil das Modell es kann. Ein knapper Kontext im VRAM schlägt einen großzügigen, der nicht mehr hineinpasst.
- Bei Ollama die voreingestellte Kontextlänge übersehen. Zu lange Eingaben werden ohne Meldung vorne abgeschnitten.
- Bei MoE-Modellen von den aktiven Parametern auf den Speicherbedarf schließen. Geladen wird das Ganze, gerechnet nur ein Teil.
- Ollama oder LM Studio als Mehrbenutzerdienst betreiben. Ohne Authentifizierung, ohne Kontingente, ohne Durchsatzoptimierung. Dafür gibt es Inference-Server.
- Lokale Modelle nach Chat-Eindruck beurteilen. Sie plaudern ordentlich und scheitern an der Werkzeugschleife. Der Test muss die tatsächliche Aufgabe sein.
- Die
.envim Kontext. Der häufigste Datenschutzvorfall im Umgang mit diesen Werkzeugen. - Ein kostenloses Chatfenster wie einen API-Zugang unter Vertrag behandeln. Rechtlich zwei verschiedene Dinge.
- Den Modellaufruf über die ganze Anwendung streuen. Ein Wechsel wird dann ein Umbau statt einer Konfigurationsänderung.
- Den Namensraum auf Hugging Face für den Hersteller halten. Die meisten GGUF-Repositories sind Derivate. Die Lizenz kommt vom Original, das Vertrauen brauchen Sie für beide.
- Annehmen, ein Cloud-Modell bleibe gleich. Verhalten ändert sich, alte Modelle werden abgeschaltet. Wer Reproduzierbarkeit braucht, muss sie planen.